Tecnologia
NVIDIA presenta un rack con 192 CPU Vera per il calcolo scientifico
La piattaforma per simulazioni è attesa dai produttori all’inizio del 2027. I test sulle CPU mostrano risultati diversi secondo il carico e non misurano le prestazioni dell’intero rack

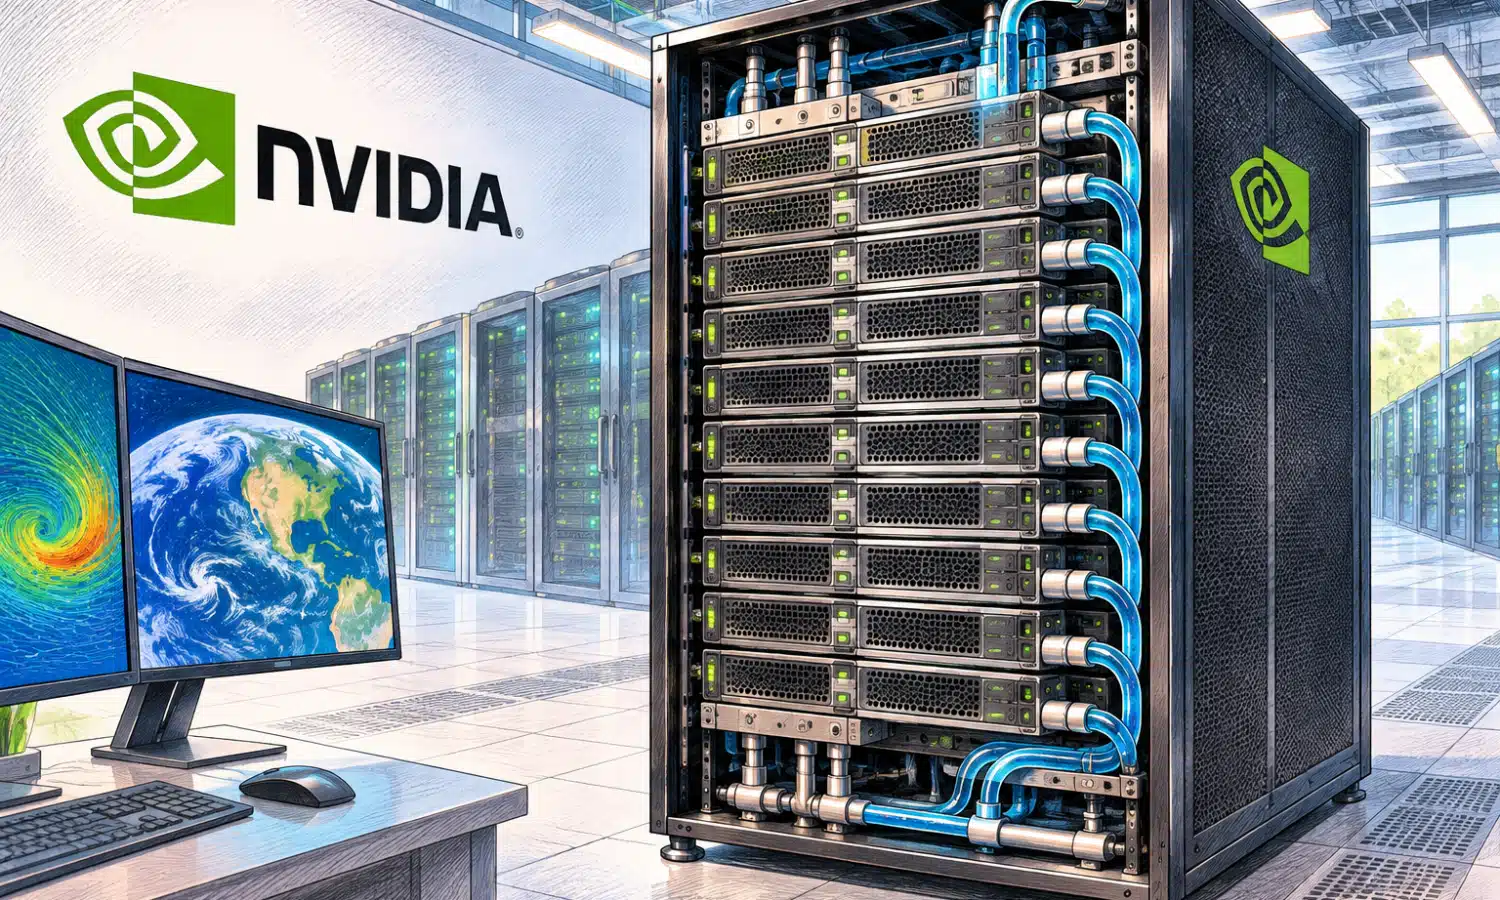
NVIDIA ha presentato una piattaforma per il calcolo scientifico che riunisce 192 CPU Vera in un rack raffreddato a liquido. Pensata per simulazioni climatiche, fluidodinamica e altri carichi di calcolo ad alte prestazioni, dovrebbe essere disponibile tramite Dell Technologies, HPE, Lenovo e Supermicro dall’inizio del 2027, secondo l’annuncio del 16 novembre 2026.
Per valutare il sistema contano non solo i processori, ma anche la velocità con cui ricevono i dati e comunicano fra nodi. I benchmark pubblicati indicano vantaggi su applicazioni specifiche, ma quelli a due processori non dimostrano che l’intero rack otterrà gli stessi risultati.
Come è costruito il rack Vera
La configurazione annunciata combina circa 300 TB di memoria, 1 petabyte di archiviazione e una rete Quantum-X800 InfiniBand. Ogni modulo di calcolo ospita otto processori. NVIDIA indica una larghezza di banda di picco aggregata della memoria superiore a 200 TB al secondo: è un valore complessivo teorico, non la velocità garantita a una singola applicazione.
Ogni CPU Vera integra 88 core Olympus, supporta 176 thread, o flussi di esecuzione, e usa memoria LPDDR5X. Il progetto riutilizza componenti dei rack NVL72, comprese parti dell’infrastruttura di alimentazione e raffreddamento. La loro integrazione va considerata nella progettazione del centro di calcolo.
Perché memoria e rete contano nelle simulazioni
In una simulazione i processori devono leggere e aggiornare grandi quantità di dati. La larghezza di banda della memoria indica quanti dati possono essere trasferiti nell’unità di tempo: se i core trascorrono molto tempo in attesa, aumentare la capacità di calcolo non produce necessariamente un’accelerazione proporzionale.
Quando il problema è distribuito fra più nodi, anche la rete incide sul risultato: le porzioni della simulazione devono scambiarsi informazioni e sincronizzarsi. Una comunicazione lenta o una suddivisione poco efficace del lavoro possono ridurre il beneficio di usare più processori.
Il legame emerge dalla prima OpenFOAM HPC Challenge, dedicata a una simulazione aerodinamica comune: tempi ed energia variavano secondo hardware, numero di nodi e scelte software. Gli autori osservano che, aumentando la scala, la comunicazione tra nodi diventa un fattore rilevante. È un contesto per interpretare Vera, non un test del nuovo rack.
Che cosa misurano i benchmark NVIDIA
Nel documento tecnico sui benchmark HPC, NVIDIA confronta sistemi con due processori Vera e due AMD EPYC 9755. Nel caso OpenFOAM motorBike Large, che simula il flusso d’aria attorno a una motocicletta, dichiara prestazioni pari a 1,9 volte e prestazioni per watt pari a 2,4 volte quelle del sistema AMD.
Il confronto riguarda le configurazioni descritte nel test, non il rack completo. I sistemi non sono identici per numero di core, memoria e altri componenti: ciascuna CPU Vera ha 88 core, mentre ogni EPYC 9755 ne ha 128. Il risultato non dimostra un vantaggio su tutti i processori x86 o su ogni applicazione.
La prestazione per watt è il rapporto fra lavoro svolto e potenza assorbita nel perimetro considerato; non coincide da sola con il consumo totale del centro di calcolo. Per confrontare l’energia necessaria a una simulazione servono anche il tempo di completamento e misurazioni coerenti dei componenti inclusi. Il documento NVIDIA non chiarisce il perimetro preciso della potenza usata nei grafici OpenFOAM e WRF.
Per il modello meteorologico WRF, NVIDIA parla nel comunicato di proiezioni di 1,6 volte le prestazioni e due volte l’efficienza energetica rispetto a x86. Il documento tecnico riporta gli stessi rapporti in un grafico che confronta due Vera con due EPYC 9755 sul caso WRF CONUS a 2,5 chilometri. Non sono una misura operativa delle previsioni meteo sull’intero rack.
Il documento descrive anche prove distribuite su un massimo di 12 nodi Vera: NVIDIA riporta fino a 2,6 volte le prestazioni della precedente piattaforma Grace nei carichi considerati e precisa che non erano disponibili cluster concorrenti per la valutazione. Anche queste prove non equivalgono a un confronto dell’intero rack da 192 CPU.
Il confronto indipendente riguarda una CPU, non 192
Uno studio dei ricercatori dell’Università di Bristol esamina un campione ingegneristico Vera a singolo processore, confrontandolo con NVIDIA Grace e con specifiche CPU AMD Turin e Intel Granite Rapids. Gli autori rilevano che Vera è il più veloce nella maggior parte dei codici esaminati e attribuiscono una parte importante del vantaggio alla banda di memoria.
Nel caso GROMACS, applicazione per la dinamica molecolare, i modelli AMD e Intel provati risultano invece più veloci. Lo studio non misura la rete InfiniBand né le prestazioni del rack completo; i risultati riguardano configurazioni precise, non tutte le CPU x86. NVIDIA ha fornito ai ricercatori l’accesso preliminare al campione Vera, come dichiarato dagli autori.
Quali dati servono per scegliere
Per trasferire i risultati alla propria infrastruttura, un centro di calcolo deve confrontare le piattaforme sullo stesso problema, con dimensioni e criteri di accuratezza equivalenti. Sono utili il tempo necessario a ottenere la soluzione, l’energia impiegata, la configurazione della memoria, il numero di nodi e il comportamento della rete quando aumenta la scala della simulazione.
Conta anche il software: Vera usa l’architettura Arm, quindi applicazioni e librerie devono essere disponibili e adeguatamente ottimizzate per la piattaforma. NVIDIA indica come disponibile l’HPC SDK 26.11, con compilatori e librerie ottimizzati per Vera. Il passaggio successivo sarà valutare configurazioni e misure dei sistemi offerti dai produttori quando i rack arriveranno sul mercato.


NVIDIA presenta un rack con 192 CPU Vera per il calcolo scientifico

IA nella pubblica amministrazione, in Gazzetta l’avviso sulle linee guida AgID

ROBOTERA apre gli ordini per la mano robotica XHAND 1 Pro-U

SwitchBot lancia Hub 4 in Europa con Matter, infrarossi e comandi vocali

ASUS porta negli USA ExpertBook B5 Flip G2 e Ultra vPro: le differenze
ASUS porta negli USA ExpertBook B5 Flip G2 e Ultra vPro: le differenze
SwitchBot lancia Hub 4 in Europa con Matter, infrarossi e comandi vocali
ROBOTERA apre gli ordini per la mano robotica XHAND 1 Pro-U